
规模化会奏效吗?
Will scaling work? [Narration]
全文文稿 · 按对话顺序保留完整内容,深入理解上下文。
§01规模化会奏效吗?
数据瓶颈、泛化基准、灵长类演化、智能即压缩、世界模型构建者,以及其他一些考量
我们什么时候该预期 AGI?
如果我们能让 LLM++ 持续规模化(并因此获得更好、更通用的表现),那么我们就有理由预期在 2040 年(或更早得多)出现强大的 AI,它能自动化大部分认知劳动,并加速 AI 的进一步进展。然而,如果规模化不奏效,那么通往 AGI 的道路看起来会长得多、也难解得多,原因我在文中有解释。
为了把关于规模化的正反论证都想透,我把这篇文章写成了我虚构的两个角色之间的辩论——信徒与怀疑者。
§02我们会用完数据吗?
我们明年就要用完高质量语言数据了。
即使认真对待那些含糊的规模化曲线,也意味着我们需要 1e35 FLOPs 才能得到一个可靠且足够聪明、能写出科学论文的 AI(这是让 AI 能够自动化进一步 AI 研究、在规模化变得不可行之后继续推动进展所需能力的门槛)1。这意味着我们需要比目前看起来拥有的多 5 个数量级(OOM)的数据2。
我担心的是,当人们听到“差 5 个数量级”时,他们的理解是:“哦,我们的数据比需要的少 5 倍——只要在数据效率上做两次 2 倍的改进,我们就大功告成了。”毕竟,朋友之间差几个数量级算什么呢?
不,差 5 个数量级意味着我们的数据比需要的少 10 万倍。是的,我们会得到数据效率稍好一些的算法。多模态训练会给我们更多数据,我们还可以在多个 epoch 上重复使用 token,并使用课程学习。但即使我们假设这些技术能带来最慷慨的一次性改进,它们也无法提供所需的指数级数据增长,以跟上这些规模化定律所要求的指数级算力增长。
于是人们又说,我们总能想办法让自我博弈/合成数据奏效。但自我博弈有两个非常困难的挑战
- 评估:自我博弈在 AlphaGo 上奏效,是因为模型可以基于一个具体的胜利条件来判断自己(“我赢了这盘围棋吗?”)。但新颖的推理并没有具体的胜利条件。因此,正如你会预期的那样,LLM 到目前为止无法纠正自己的推理。
- 算力:所有这些数学/代码方法往往使用各种树搜索,在每个节点上反复运行 LLM。AlphaGo 为“赢下围棋”这个相对受限的任务所消耗的算力预算已经惊人——现在想象一下,你要搜索的不是围棋落子的空间,而是所有可能的人类思想的空间。让自我博弈奏效所需的这些额外算力,是在为规模化参数本身已经需要的巨额算力增长之外额外叠加的(算力 = 参数 × 数据)。按人类水平思维需要 1e35 FLOPs 的估算,我们需要在今天最大的模型之上再多 9 个数量级的算力。是的,更好的硬件和更好的算法会带来改进,但你真的能拿到相当于整整 9 个数量级的改进吗?
如果你反对规模化奏效的主要理由只是缺数据,那么你的直觉反应不该是:“好吧,看来我们本可以通过放大 transformer++ 造出 AGI,但我想我们会先用完数据。”
你的反应应该是:“我的天,如果互联网大得多,放大一个我可以用几百行 Python 写出其基本结构的模型,本可以造出人类水平的心智。‘把一大坨算力变成智能’竟然这么容易,这是关于这个世界的一个疯狂事实。”
LLM 表现“低效”的那个样本,大部分只是无关的电商垃圾3。我们还通过让它们预测下一个 token 来加剧这一缺陷——这个损失函数与我们真正希望智能体在经济中完成的任务几乎毫无关系。而尽管我们真正想要的能力、糟糕的损失函数和训练数据之间只有这么微小的交集,我们只要把微软年收入的 0.03% 砸向一次大规模互联网抓取,就能造出一个婴儿版 AGI(也就是 GPT-4)。
所以,考虑到 AI 进展到目前为止如此轻松简单,如果合成数据也照样奏效,我们不该感到意外。毕竟,“模型就是想要学习”。
GPT-4 发布才 8 个月。其他 AI 实验室才刚刚拿到自己的 GPT-4 级别模型。这意味着所有研究者现在才刚开始着手让自我博弈在当前这一代模型上奏效(而且看起来其中一家可能已经成功了)。因此,目前我们没有公开证据表明合成数据在大规模上奏效,并不意味着它不可能。
毕竟,当你的基础模型足够有能力、至少有时能给出正确答案时,RL 就变得可行得多(现在你可以奖励那 1/100 次模型完成长数学证明所需思维链、或写出完成一个完整 pull request 所需的 500 行代码的时刻)。很快你的 1/100 成功率会变成 10/100,然后 90/100。现在你去试 1000 行的 pull request,模型不仅有时会成功,而且失败时还能批评自己。以此类推。
事实上,这种合成数据的自举过程,看起来几乎直接类比于人类的演化。我们的灵长类祖先几乎没有证据表明能够迅速辨别并应用新的洞见。但一旦人类发展出语言,你就有了这种基因与文化的共同演化,它非常类似于 LLM 的合成数据/自我博弈回路——模型变得更聪明,是为了更好地理解同类副本所产生的复杂符号输出。
自我博弈并不要求模型在评判自己的推理上做到完美。它们只需要在评估推理上比从零开始做推理更强(这显然已经是事实——见 Constitutional AI,或者只是和 GPT 玩几分钟,注意它在解释你写下的东西为什么错时,似乎比它自己想出正确答案更擅长)4。
我交谈过的大型 AI 实验室里的研究者,几乎都相当确信他们能让自我博弈奏效。当我问他们为什么这么确定时,他们会停顿一下,像是迫不及待要解释他们所有的想法。但随后他们想起保密是回事,就说:“我不能告诉你具体细节,但我们在这里可以尝试的东西里有太多低垂的果实。”或者像 Dario Amodei(Anthropic 的 CEO)在我的播客上对我说的:
你提到数据很可能不会是约束。你为什么这么认为?
这里有各种可能性,出于若干原因我不便细说,但世界上有很多数据来源,也有很多生成数据的方法。我的猜测是,这不会成为阻碍。
也许它成为阻碍反而更好,但它不会。
Constitutional AI、RLHF 以及其他 RL/自我博弈设置,擅长把潜在能力引出来(或在能力不乖时把它们压下去)。但还没有人展示出一种方法,能用 RL 真正提高模型的底层能力。
如果某种自我博弈/合成数据不奏效,那你就彻底完蛋了——绕过数据瓶颈没有别的路。新架构极不可能提供解决方案。你需要一次比 LSTM 到 transformer 更大的样本效率跃升。而 LSTM 早在 90 年代就被发明出来了。所以你需要一次比我们在二十多年里、在深度学习的低垂果实最容易摘取的时期所获得的更大的跃升。
那些在情感上或财务上希望看到 LLM 规模化的人给你的“感觉”,无法替代我们实际上拥有的证据——而我们完全没有证据表明 RL 能补上数据上这许多个数量级的缺口。
此外,LLM 似乎需要如此巨量的数据才能得到如此平庸的推理,这本身就表明它们根本没有泛化。如果这些模型用一个人两万年才能看完的数据都无法接近人类水平的表现,我们就应该考虑这种可能:二十亿年的数据同样不够。你往飞机里加多少航空燃油,都不可能让它飞到月球。
§03到目前为止,规模化真的奏效过吗?
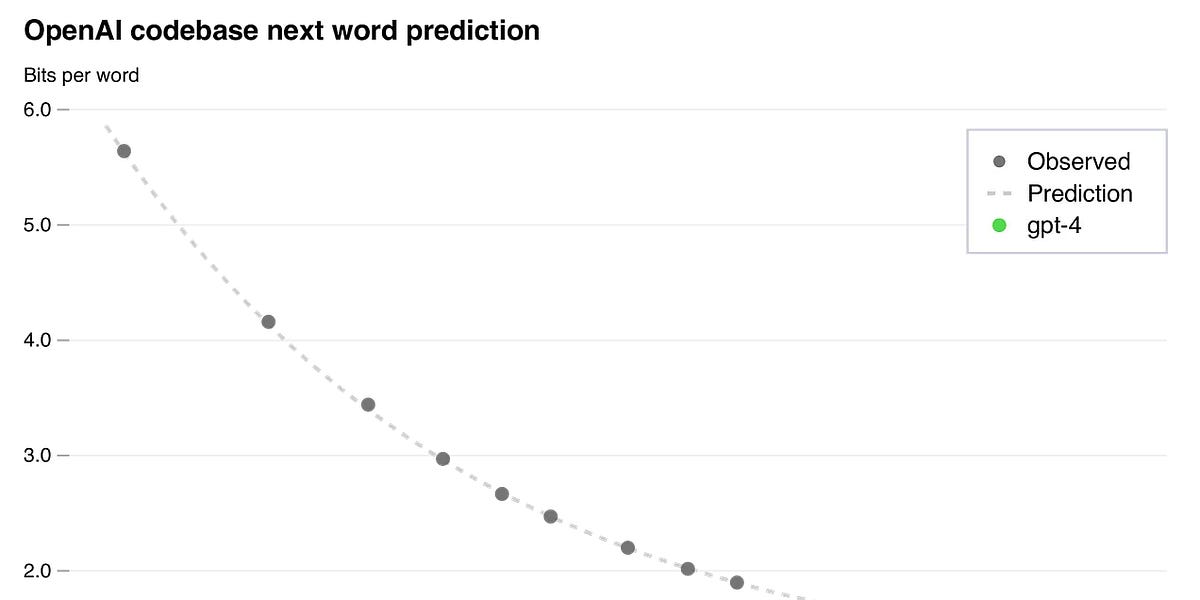
你在说什么?基准表现已经连续跨越 8 个数量级保持一致地规模化。在算力增长上百万倍的过程中,模型表现的损失精确到小数点后很多位。
在 GPT-4 的技术报告里,他们说能够预测最终 GPT-4 模型的表现,依据是“用同样方法训练、但算力最多比 GPT-4 少 10000 倍的模型”。
我们应该假定,一个在过去 8 个数量级上如此稳定奏效的趋势,在接下来的 8 个数量级上也会可靠。而从再放大 8 个数量级(或者考虑到算法与硬件进步带来的免费性能提升,在性能上等同于放大 8 个数量级)所能达到的表现来看,很可能产生足够有能力加速 AI 研究的模型。
但当然,我们并不直接关心下一个 token 预测的表现。模型在这个损失函数上早已击败人类。我们想知道的是,这些关于下一个 token 预测的规模化曲线,是否真的对应着朝向通用性的真实进步。
随着你放大这些模型,它们在 MMLU、BIG-bench 和 HumanEval 等基准所衡量的广泛任务上,表现持续且可靠地提升。
但你真的看过 MMLU 和 BigBench 里随机抽取的题目吗?它们几乎全都是谷歌搜索的第一条结果。它们是很好的记忆测试,而不是智力测试。以下是我从 MMLU 随机挑的一些题目(记住——这些是选择题,模型只需从四个选项里挑出正确答案):
问:按照 Baier 的理论,评估一个行为在道德上是否被允许的第二步,是查明
答:禁止该行为的道德规则是否是一条真正的道德规则。
问:关于自发过程,下列哪项总是成立?
答:系统加环境的熵增。
问:比尔·克林顿出生时,谁是美国总统?
答:哈里·杜鲁门
一个在充满随机事实的互联网文本上训练出来的模型,恰好记住了大量随机事实,这有什么了不起的?这又怎么能以任何方式表明智力或创造力?
而且即使在这些刻意设计、与真实能力正交的基准上,表现似乎也在趋于平台。谷歌新的 Gemini Ultra 模型估计拥有比 GPT-4 多近 5 倍的算力,但它在 MMLU、BIG-bench 和其他标准基准上的表现几乎相当。
无论如何,常见基准完全不能衡量长周期任务表现(你能在一个月的时间里完成一份工作吗),而在这种任务上,用下一个 token 预测训练的 LLM 只有极少的有效数据点可学。确实,从它们在 SWE-bench(衡量 LLM 能否自主完成 pull request)上的表现可以看到,它们在跨长周期整合复杂信息方面相当糟糕。GPT-4 只拿到可怜的 1.7%,Claude 2 稍好一点,4.8%。
我们似乎有两种基准:
- 衡量记忆、回忆和插值的那一类(MMLU、BIG-bench、HumanEval),这些模型看起来已经追平甚至超过普通人。这些测试显然不能作为智力的好代理,因为即使是一个规模最大化主义者也必须承认,模型目前比人类笨得多。
- 真正衡量跨长时间跨度或困难抽象自主解决问题能力的那一类(SWE-bench、ARC),这些模型连参赛资格都谈不上。
对于一个在相当于两万年人类输入的数据上训练之后,仍然不明白“如果汤姆·克鲁斯的母亲是 Mary Lee Pfeiffer,那么 Mary Lee Pfeiffer 的儿子就是汤姆·克鲁斯”的模型,我们该得出什么结论?或者对于答案极度依赖问题措辞方式和顺序的模型,我们该得出什么结论?
所以,现在甚至还不值得问规模化是否会继续奏效——我们似乎连规模化到目前为止奏效过的证据都没有。
Gemini 恰恰是一个最不适合预期出现平台的奇怪位置。GPT-4 显然已经突破了怀疑者对联结主义和深度学习预先登记的所有批评5。关于 Gemini 相对 GPT-4 的表现,更合理的解释只是:谷歌还没有完全追上 OpenAI 的算法进展。
如果深度学习和 LLM 存在某个根本性的硬天花板,我们不该在它们开始发展常识、早期推理和跨抽象思考能力之前就看到它吗?从表面上看,有什么理由预期顽固的极限恰好出现在平庸推理和高级推理之间?
想想 GPT-4 比 GPT-3 好多少。那只是 100 倍的放大。听起来很多,直到你考虑到这比我们还能投给这些模型的额外放大要小得多。在只动用全球 GDP 的百分之一之前,我们还负担得起把 GPT-4 再放大 10000 倍(也就是 GPT-6 级别的东西)。而这还没有算上预训练算力效率的提升(混合专家、flash attention 之类)、新的后训练方法(RLAI、思维链微调、自我博弈等)以及硬件改进。其中每一项单独贡献的性能,都相当于许多个数量级的原始放大所能带来的(过去它们确实一直如此)。把所有这些加在一起,你大概能把 1% 的 GDP 转换成 GPT-8 级别的模型。
为了解社会愿意为新的通用技术花多少钱,做个参照:
- 英国铁路投资在 1847 年的峰值高达其 GDP 的 7%。
- “在 1996 年《电信法》生效后的五年里,电信公司投入了超过 5000 亿美元[按今天的价值接近一万亿]……用于铺设光缆、增加新的交换机、建设无线网络。”
有可能 GPT-8(也就是性能相当于放大一亿倍的 GPT-4 的模型)只会比 GPT-4 稍好一点,但我不理解为什么你会这样预期,因为我们已经看到模型在远小得多的放大倍数下就搞清楚了如何思考、世界是什么样的。
后面的故事你都知道——数百万个 GPT-8 副本编写内核改进、寻找更好的超参数、给自己提供大量高质量反馈用于微调,等等。这让开发 GPT-9 变得便宜和容易得多……把这个过程外推到奇点。
§04模型理解世界吗?
为了预测下一个 token,LLM 必须自学所有那些导致一个 token 跟在另一个 token 之后的世界规律6。要预测《自私的基因》某一段的下一段,需要理解以基因为中心的演化观;要预测一篇新短篇小说的下一段,需要理解人类角色的心理,等等。
如果你用代码训练一个 LLM,它在语言中的推理会变好。这真是一个令人震惊的事实。它告诉我们,模型从阅读海量代码中挤压出了某种关于如何思考的深层通用理解——不仅语言和代码之间存在某种共享的逻辑结构,而且无监督学习可以提取这个结构,并利用它来更好地推理。
梯度下降试图找到其数据最有效的压缩。最有效的压缩同时也是最深刻、最强大的。对一本物理教科书最有效的压缩——那种能帮你预测书里一个被截断的论证接下来会如何展开的压缩——就是对底层科学解释的深度内化理解。
智能(除其他因素之外)涉及压缩的能力。但压缩本身不是智能。爱因斯坦聪明是因为他能想出相对论,但“爱因斯坦+相对论”并不是一个在对我有意义的层面上更聪明的系统。说柏拉图和我加上我的知识相比是个白痴,这没有意义,因为他没有我们对生物学或物理学的现代理解。
所以,如果 LLM 只是另一个过程(随机梯度下降)所做的压缩,那我不知道这为什么能告诉我们任何关于 LLM 自身做出压缩能力的事情(因此也不知道它为什么能告诉我们任何关于 LLM 智力的事情)7。
要让规模化继续奏效,并不需要一个无懈可击的理论解释。蒸汽机发明之后一个世纪,我们才发展出对热力学的完整理解。技术史上的常见模式是发明先于理论,我们对智能也应作同样预期。
并没有什么物理定律说摩尔定律必须延续。事实上,总会有新的实际障碍暗示摩尔定律的终结。然而每隔几年,台积电、英特尔、AMD 等的研究者就想出办法解决这些问题,给这个持续数十年的趋势续上一段命。
你可以做所有这些关于算力和数据瓶颈、智能的真正本质以及基准脆弱性的脑力体操。或者你干脆就看看那条该死的曲线。
§05结论
分身扮演到此为止。以下是我个人的看法。
如果你在过去几年里是一个规模化的信徒,我们所看到的进展本来会显得更顺理成章。你当然可以讲一个故事,说 GPT-4 惊人的表现可以用某个永远不会泛化的惯用语库或查找表来解释。但那是没有一个怀疑者事先登记过的故事。
至于信徒一方,像 Ilya、Dario、Gwern 这样的人,早在 12 年前就或多或少地把我们因规模化而看到的缓慢起飞讲清楚了。
看起来相当清楚的是,某种程度的规模化可以把我们带到变革性 AI——也就是说,如果你在这些规模化曲线上达到不可约的损失,你就造出了一个聪明到足以自动化大部分认知劳动(包括制造更聪明 AI 所需的那部分劳动)的 AI。
但生活里的大多数事情都比理论上更难,而许多理论上可能的事情出于这样或那样的原因一直难以攻克(聚变发电、飞行汽车、纳米技术等)。如果自我博弈/合成数据不奏效,模型看起来就完蛋了——你永远无法接近那个柏拉图式的不可约损失。而且,预期规模化继续奏效的理论理由模糊不清,而规模化似乎能带来更好表现的那些基准,其通用性也值得商榷。
所以我暂定的概率是:70%:规模化+算法进步+硬件进步会在 2040 年前把我们带到 AGI。30%:怀疑者是对的——LLM 以及任何大致在同一路数上的东西都完蛋了。
我大概漏掉了一些关键证据——AI 实验室根本没有发布那么多研究,因为任何关于“AI 科学”的洞见都会泄露与构建 AGI 相关的想法。一位在这些实验室之一做研究的朋友告诉我,他很怀念本科时靠读一堆论文来放松的习惯——如今,没有任何值得读的东西被发表出来。因为这个原因,我假定那些我不知道的东西会缩短我的时间表。
另外,顺便说一句,我的日常工作是播客主持人。但那些能写出更好文章的人,因为保密或机会成本而写不了。所以请体谅我一下,并在评论里告诉我我漏了什么。
§06附录
以下是一些额外的考量。我不觉得自己对这些主题理解得足够好,无法完全弄清它们对规模化意味着什么。
§07模型会获得基于洞察的学习能力吗?
在更大的规模上,模型会自然地发展出更高效的元学习方法——grokking 只在你有大型过参数化模型、并且越过那个把它训练到严重过拟合数据的点之后才会发生。Grokking 看起来非常像我们学习的方式。我们有直觉和对新信息进行分类的心智模型。随着时间推移和新的观察,这些心智模型本身也在改变。在如此多样的数据上做梯度下降,会筛选出最通用、最具外推能力的回路。于是我们得到 grokking——最终我们会得到基于洞察的学习。
神经网络有 grokking,但那比人类实际整合新的解释性洞察的效率低了好几个数量级。你告诉一个孩子太阳位于太阳系的中心,这会立刻改变他对夜空的解释方式。但你不能只把一个哥白尼的副本喂给一个没受过任何天文学训练的模型,就让它立刻把那个洞察纳入所有相关的未来输出。模型必须在如此多的不同语境中听到信息如此多次才能“grok”底层概念,这很奇怪。
模型不仅从未展示过洞察式学习,而且我看不出鉴于我们用梯度下降训练神经网络的方式,这种学习怎么可能发生——我们对每个样本给它们一堆非常细微的推动,希望足够多这样的推动会慢慢把它们推到正确山峰的顶上。基于洞察的学习需要从海平面直接瞬移到珠穆朗玛峰顶。
§08灵长类演化提供了规模化的证据吗?
我相信你能在黑猩猩认知中找到各种这类令人尴尬的脆弱之处,比“反转诅咒”更能说明问题。但这并不意味着灵长类大脑存在某个根本极限,无法用 3 倍规模加上一些微调来修复。
确实,正如 Suzana Herculano-Houzel 所展示的,人脑拥有的神经元数量,正好相当于一个质量与人脑相同的、被放大后的灵长类大脑所应有的数量。啮齿类和食虫类大脑的规模化定律要差得多——这些目里相对脑容量更大的物种,其神经元数量远少于仅从脑质量所预期的数量。
这表明存在某种灵长类神经架构,相比其他物种的大脑具有真正的可扩展性,类似于 transformer 比 LSTM 和 RNN 有更好的规模化曲线。演化在设计灵长类大脑时学会(或至少撞上了)苦涩的教训。而灵长类竞争所处的生态位,强烈奖励智力的边际提升(你必须理解来自双眼视觉、会使用工具的手,以及其他会跟你说话的聪明猴子的所有这些数据)。
非常感谢 Chris Painter、James Bradburry、Kipply、Jamie Sevilla、Tamay Besiroglu、Matthew Barnett、Agustin Lebron、Anil Varanasi 和 Sholto Douglas 的评论与讨论。