
为什么我认为 AGI 不会很快到来
Why I don’t think AGI is right around the corner
全文文稿 · 按对话顺序保留完整内容,深入理解上下文。
本篇目录1 章节
§01文稿§01文稿
好,这是我在 2025 年 6 月 3 日写的一篇博文的朗读版,标题是《为什么我认为 AGI 不会很快到来》。引用一句:事情发生得比你想象的更晚,然后又比你想象的更快。鲁迪格·多恩布什。在我的播客里,我有很多次和嘉宾反复争论 AGI 的时间表。有些嘉宾认为还有 20 年,另一些认为只有两年。以下是我在 2025 年 6 月的想法。先说持续学习。有时人们会说,即使 AI 进展完全停止,今天的系统在经济上的变革性仍然会远超互联网。我不同意。
我认为今天的 LLM 很神奇,但财富 500 强企业没有用它们来改造自己的工作流,原因并不是管理层太保守。相反,我认为要让 LLM 产出像普通人那样的劳动成果,真的很难。这与这些模型缺乏的一些基础能力有关。我愿意认为自己在这个 Dwarkesh 播客里是偏向 AI 的,我大概花了 100 个小时左右,试着为我的后期制作流程搭建这些小 LLM 工具。而试着让这些 LLM 变得有用的经历,反而延长了我的时间表。我会试着让它们像人一样重写自动生成的文稿,使其可读;或者让它们从文稿里找出可以发推的片段。
有时我会让它们和我一起一段一段地合写一篇文章。这些都是简单、自包含、短周期、语言进语言出的任务,本该正好落在 LLM 的看家本领范围内,而这些模型在这类任务上的水平是五分(满分十分)。别误会,这已经很惊人了。但根本问题在于,LLM 不会像人那样随着时间变得更好。这种持续学习的缺失是一个极其、极其严重的问题。LLM 在许多任务上的基线可能高于普通人,
但你没有办法给模型高层次的反馈。你只能用它开箱即得的能力。你可以不断折腾系统提示词,但在实践中,这根本产生不了接近人类员工在实际工作中所经历的那种学习和进步。人之所以如此宝贵、如此有用,主要不是因为他们的原始智力。
而是因为他们能够积累上下文、追问自己的失败,并在反复练习一项任务时获得微小的改进和效率提升。你怎么教一个孩子吹萨克斯?你让她试着吹一下,听听声音怎么样,然后调整。现在,想象一下如果教萨克斯是这样进行的。
一个学生尝试一次,一旦犯错,你就把他打发走,然后写下详细的说明,指出哪里错了。接着下一个学生读你的笔记,直接试着凭记忆吹出 Charlie Parker 的曲子。等他们失败了,你再为下一个学生改进说明。这根本行不通。无论你的提示词打磨得多好,
也不会有哪个孩子光靠读你的说明就学会吹萨克斯。但这是我们作为用户教 LLM 任何东西的唯一通道。是的,有 RL 微调,但它并不是像人类学习那样一个有意识的适应过程。我的编辑们变得极其出色,而如果他们工作的每一个不同子任务都需要专门搭建 RL 环境,
他们不可能变得那么出色。他们只是自己注意到了很多细微之处,认真思考了什么能引起听众共鸣、什么样的内容让我兴奋,以及他们如何改进自己的日常工作流。现在,可以想象一个更聪明的模型为自己搭建专门的 RL 回路,
从外部看这非常有机。我给出一些高层次反馈,模型自己设计出一批可验证的练习题来做 RL,甚至搭建一整个环境来排练它认为自己欠缺的技能。但这听起来真的很难,而且我不知道这些技术能多好地泛化到不同种类的任务和反馈上。最终,模型会能够边工作边学习,
以人类那种细微而有机的方式。然而,考虑到目前没有明显办法把在线持续学习嵌入到这些 LLM 所属的模型类型里,我很难看到这在未来几年内发生。不过,LLM 在一次会话的中途确实会变得聪明一些。比如,有时我会和一个 LLM 合写文章。我给它一个提纲,让它一段一段地起草。到第四段为止,它所有的建议都很差。
于是我就把整段从头重写,告诉它:嘿,你写的东西很烂,这是我改写的版本。到那个时点,它确实开始能为下一段给出好建议了。但所有这些关于我的偏好和风格的细微理解,在会话结束时都丢失了。也许简单的解决方案看起来像是一个很长的滚动上下文窗口,就像 Claude Code 那样,每 30 分钟把会话记忆压缩成一份摘要。
我只是认为,把所有这种丰富、默会的经验滴定成一段文字摘要,在软件工程以外的领域会很脆弱,而软件工程是非常依赖文本的。再想想用一份长长的文字摘要去教别人吹萨克斯的例子。甚至 Claude Code 也常常在我输入斜杠 compact 之前,把我们好不容易一起做出来的某项优化给改回去,因为做这项优化的理由没有进入摘要。这就是为什么我不同意 Sholto 和 Trenton 在我播客上说的某些话,下面这句引用来自 Trenton。即使 AI 进展完全停滞,你也认为这些模型非常参差不齐、不具备通用智能,它们在各个不同的白领工作任务上依然极具经济价值,而且收集这些数据足够容易,
以至于按 Sholto 的说法,我们应该预期它们在未来五年内被自动化。如果 AI 进展今天完全停滞,我认为消失的白领岗位不到 25%。当然,很多任务会被自动化。Claude 4 Opus 在技术上可以为我重写自动生成的文稿。但由于我无法让它随时间改进并学会我的偏好,我仍然为这件事雇了人。即使我们获得更多数据,在没有进展和持续学习的情况下,我认为整个白领工作领域仍会处于基本相似的境地。是的,从技术上讲,AI 也许能相当令人满意地完成很多
子任务,但它们无法积累上下文,这使得它们不可能在你的公司里充当真正的员工。那么,虽然这让我对未来几年的变革性 AI 持看空态度,但它让我对未来二十年的 AI 格外看多。当我们真正解决持续学习时,我们会看到这些模型价值上的巨大断层。即使不存在一个纯软件式的奇点、由模型快速造出越来越聪明的后继系统,我们可能仍会看到某种看起来像广泛部署的智能爆炸。
AI 将在整个经济中广泛部署,做不同的工作,并在做的过程中像人一样学习。但与人不同,这些模型可以把各自学到的东西在所有副本之间合并。所以一个 AI 基本上是在学习如何做世界上的每一份工作。一个具备在线学习能力的 AI,可能不需要任何进一步的算法进步,就在功能上迅速成为超级智能。不过,我并不期待看到某场 OpenAI 直播宣布持续学习已经被彻底解决。
因为实验室有动力尽快发布任何创新,我们会在看到真正像人一样学习的东西之前,先看到一个有点残缺的早期版本——持续学习,或者叫测试时训练,随便你怎么称呼它。我预期在看到这个大瓶颈被彻底解决之前,会先得到很多预警。接下来说电脑操作。当我采访 Anthropic 的研究者 Sholto Douglas 和 Trenton Bricken
时,他们说预期明年年底会出现可靠的电脑操作智能体。现在我们已经有了电脑操作智能体,但它们相当糟糕。他们想象的是完全不同的东西。他们的预测是,到明年年底,你应该能对一个 AI 说:去帮我报税。它会去查你的邮件、亚马逊订单和 Slack 消息。
它会给所有你需要发票的对象来回发邮件。它汇总你所有的收据。它判断哪些属于业务支出,在边界情况上请你批准,然后把 1040 表提交给美国国税局。我持怀疑态度。我不是 AI 研究者,所以在技术细节上不宜反驳他们,但就我所知道的那一点点而言,
以下是我打赌这项能力不会在明年内解锁的三个理由。第一,随着时间跨度变长,rollout 必须变得更长。AI 需要先完成两小时规模的智能体式电脑操作任务,我们才能看到它做得对不对。更不用说电脑操作需要处理图像和视频,这本身就更耗算力,即使不把更长的 rollout 算进去。这看起来应该会拖慢进展。第二,我们没有大规模的预训练
多模态电脑操作数据语料。我喜欢 Mechanize 那篇《自动化软件工程》文章里的这句话。引用:过去十年的规模化里,我们被互联网上大量免费可得的文本数据惯坏了。这足以攻克自然语言处理,但不足以让模型成为可靠、称职的智能体。想象一下,用 1980 年所有可得的文本数据来训练 GPT-4。即使你有必要的算力,数据也远远不够,引用结束。再次强调,我不在实验室里,所以也许纯文本训练已经给了你一个很好的先验,让你知道不同 UI 如何运作、不同组件之间是什么关系。也许 RL 微调的样本效率高到你不需要那么多数据。
但我没有看到任何公开证据让我认为这些模型突然变得不那么需要数据了,尤其是在它们明显更不熟练的领域。另一种可能,也许这些模型是极好的前端程序员,可以为自己生成数百万个玩具 UI 来练习。关于我对这一点的反应,见下面的要点。第三,即使是事后看来相当简单的算法创新,似乎也花了很长时间才打磨出来。DeepSeek 在 R1 论文里解释的 RL 流程,在高层次上看似乎很简单。而从 GPT-4 发布到 o1 发布,花了两年。当然,我知道说 R1 或 o1 很容易是荒谬的傲慢。
我相信为了得到那个解决方案,需要大量的工程、调试以及对替代想法的剪枝。但这恰恰是我的观点。看到实现这个想法花了多久——嘿,让我们训练模型去解决可验证的数学和编程问题——让我认为,我们低估了解决电脑操作这个更加棘手问题的难度,因为你在那里操作的是完全不同的模态,数据也少得多。接下来说推理。好,冷水泼够了。我不会像 Hacker News 上那些被惯坏的孩子一样,
就算递给他们一只下金蛋的鹅,他们也会把所有时间都花在抱怨它叫得太响上。你读过 o3 或 Gemini 2.5 的推理轨迹吗?那确实是在推理。它在拆解问题。它在思考用户想要什么。它会对自己的内心独白作出反应,并在注意到自己正朝着无益的方向前进时纠正自己。我们怎么会就这么觉得,是啊,机器当然会去思考一堆、想出一堆想法,然后带回一个聪明的答案。
机器就是干这个的。有些人过于悲观的部分原因是,他们没有在那些最聪明的模型最擅长的领域里玩过这些模型。给 Claude Code 一个含糊的规格说明,然后坐着等十分钟,看它一次性交付一个能用的应用,这是一种疯狂的体验。它是怎么做到的?你可以谈电路、训练分布和 RL 之类的,但最贴近、最简洁也最准确的解释就是:它由婴儿期的通用智能驱动。到这个时候,你心里有一部分必然在想:它真的在起作用。
我们正在造出有智能的机器。好,那我的预测是什么?我的概率分布非常宽,而且我想强调,我确实相信概率分布,这意味着为 2028 年出现对齐失败的 ASI 做准备仍然很有意义。我认为那完全是一个可能的结果。但以下是我愿意下五五赌注的时间点,
一个 AI 能端到端地为我的小公司报税,水平堪比一位称职的总经理在一周内能做到的——包括追查不同网站上的所有收据、找出所有缺失的碎片、和任何需要催发票的人来回发邮件、填好表格并寄给美国国税局。2028 年。我认为在电脑操作上我们正处于 GPT-2 时代,但我们没有预训练语料,而模型正在用它们不熟悉的动作原语、在长得多的时域上优化一个稀疏得多的奖励。
话虽如此,基础模型本身相当聪明,可能对电脑操作任务有不错的先验。再加上世界上有更多算力和更多 AI 研究者,所以也许能扯平。为小企业报税这件事,在电脑操作领域大概相当于 GPT-4 在语言领域的地位。而从 GPT-2 到 GPT-4 花了四年。澄清一下,我不是说 2026 和 2027 年不会有非常酷的电脑操作演示。
GPT-3 非常酷,但实用价值没那么大。我的意思是,这些模型无法端到端地处理一个为期一周、相当复杂、涉及电脑操作的项目。好,另一个预测是这样的:一个 AI 能像人一样轻松、有机、无缝且迅速地边工作边学习任何白领工作。举例来说,如果我雇一个 AI 视频剪辑师,
六个月后,它对我的偏好、我们的频道以及什么内容对听众有效,有着和人类一样多可执行的、深入的理解。这个我会说是 2032 年。现在,虽然我看不出有什么明显办法把持续在线学习嵌进当前的模型,
但七年是非常长的时间。七年前的这个时候,GPT-1 才刚刚发布。对我来说,未来七年里我们找到某种让这些模型边工作边学习的办法,并不显得不可信。好,到这一步你可能会反应:看,你对持续学习是多么大的缺陷大做文章,可你的时间表却是我们距离一个至少是广泛部署的智能爆炸只有七年。是的,你说得对。我预测的是一个相当疯狂的世界,
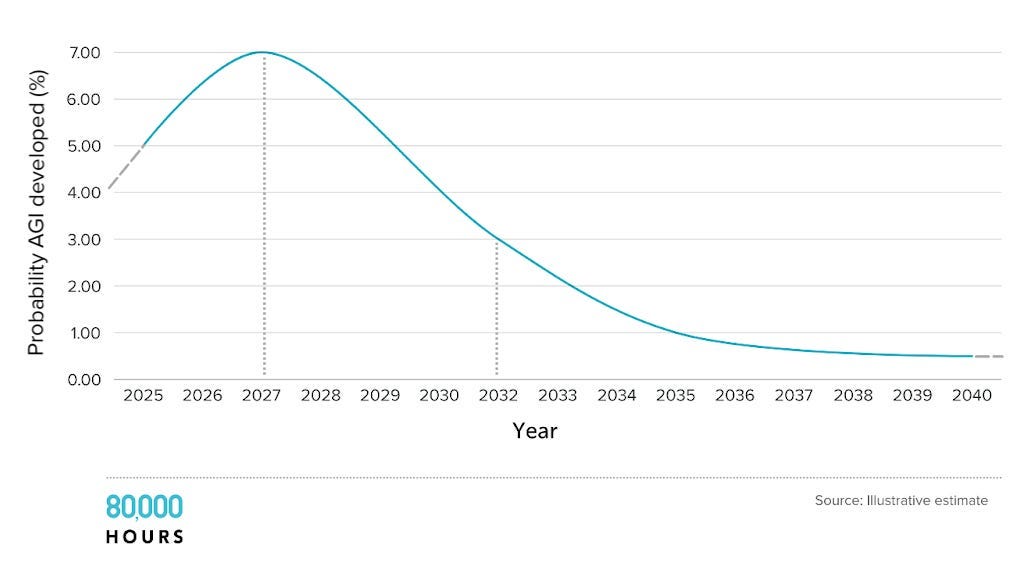
而且是在相对很短的时间里。AGI 的时间表非常符合对数正态分布。要么在这十年,要么就完蛋。其实不是真的完蛋,更像是每年的边际概率下降,但那样说不够抓人。过去十年 AI 的进展是由前沿系统的训练和算力规模化推动的,每年超过 4 倍。这不可能在这十年之后继续下去,无论你看芯片、电力,甚至只是用于训练的 GDP 占比。2030 年之后,AI 的进展必须主要来自算法进步。
但即便在算法上,低垂的果实也会被摘完,至少在深度学习范式下是如此。所以 AGI 的年度概率在 2030 年之后会断崖式下跌。这意味着,如果我们最终落在我那些五五赌注中较长的那一侧,我们很可能看到一个直到 2030 年代甚至 2040 年代都相对正常的世界。但在所有其他世界里,即使我们对 AI 当前局限保持清醒,
我们也必须预期一些真正疯狂的结果。你们中很多人可能不知道,我还有一个博客,我想把那里的内容带给你们这些主要订阅播客的人。如果你想读未来的博文,请在 dwarkesh.com 订阅我的通讯。否则,感谢收听,我们下期再见。