
规模化会奏效吗?
Will scaling work? [Narration]
In-depth read · Key ideas, reasoning, and examples, organized by topic.
§01框定问题:信徒与怀疑者之间的辩论
本期节目朗读的是一篇写成正式辩论的文章,辩论双方是作者虚构的两个角色:信徒与怀疑者。这个设计对理解全文很重要。Patel 的框定是一个条件命题:如果 LLM 及其后继者能持续规模化、并因此变得更通用,那么到 2040 年(或更早得多)出现能自动化大部分认知劳动的强大 AI,就是一个合理预期;如果规模化失败,通往 AGI 的道路就会长得多、也更难看清楚。文章的任务是检验这个前提,而不是假定它成立。
副标题列出了这场辩论将涉及的考量:数据瓶颈、泛化基准、灵长类演化、智能即压缩、世界模型。这份清单值得一直记着,因为文章的结论不是某一方在某个决定性论点上获胜,而是这些战线上的证据参差不齐,结尾给出的概率正是这种参差的反映。
§02数据瓶颈,诚实地陈述
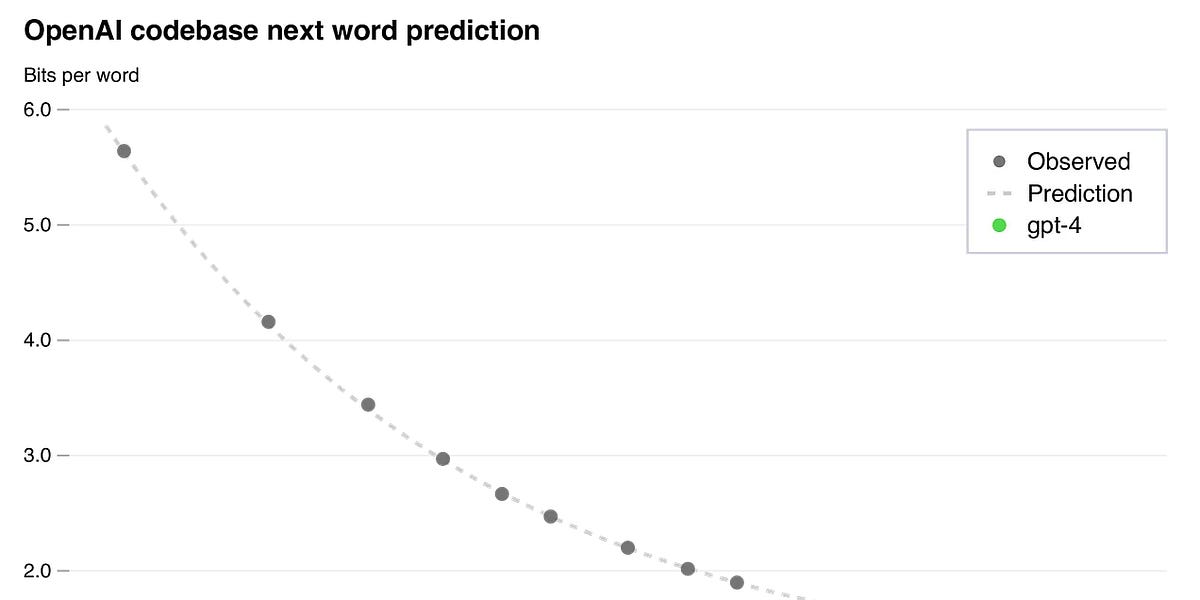
怀疑者以手头最锐利的具体反对开场:高质量语言数据明年就会用完。Patel 随后让算术发挥作用。即使认真对待宽松的规模化曲线,也意味着要得到一个可靠且聪明到能写科学论文的模型,大约需要 1e35 FLOPs——文中把这当作自动化 AI 研究的门槛——而这又意味着需要比现有数据多大约五个数量级的数据。
这一节在修辞上的核心,是提醒人们会怎样误读数量级。听到“差五个数量级”,听众会把它翻译成“只要在效率上做两次 2 倍的改进”。纠正之处在于:五个数量级是十万倍的缺口;而现有的一次性补救——更高效的算法、多模态数据、在相同 token 上跑多个 epoch、课程学习——都不是像算力趋势那样的指数型增长。这是全文最有用的一段:它把关于数据的模糊担忧转换成一个无法用几个工程技巧打发掉的数量。
差 5 个数量级意味着我们的数据比需要的少 10 万倍。
Keep reading as a member.
You've read the free preview. Become a member to read the rest, with side-by-side reading and downloads where available.